人工智能应用不断进入企业生产环境,大模型训练、AI推理、数字人、视觉识别、AIGC及高性能计算等业务,对GPU算力的需求持续增长。
对于企业而言,AI项目往往具有明显的阶段性。模型研发可能需要短期大量算力,正式上线后又转向长期推理;创业团队需要控制前期投入,成熟企业则更关注服务器稳定性、网络质量和后续扩容。
在这种情况下,GPU服务器租赁相比一次性采购硬件,为企业提供了一种更加灵活的算力部署方式。
龙泽智能云依托郑州、香港等IDC基础设施资源,围绕GPU服务器租赁、服务器租用及算力基础设施提供多样化服务,可根据企业不同业务阶段匹配相应的服务器和网络环境。
一、GPU服务器租赁,解决企业算力部署的成本问题
传统GPU部署通常需要一次性采购服务器、GPU、存储和网络设备,同时还要解决机房、电力、制冷和运维问题。
对于刚开始做AI项目的企业来说,这种投入并不一定合理。
如果模型还处于测试阶段,购买大量GPU很容易出现闲置;如果业务快速增长,又可能遇到现有设备算力不足的问题。
GPU服务器租赁则可以根据实际项目进行配置。
需要训练时租用GPU;需要推理时长期使用;业务增长后增加资源。
企业无需提前为未来几年购买大量固定硬件,可以让算力投入更加贴近实际业务需求。
二、现在选择GPU服务器,不能只看“GPU有几张”
过去用户选择GPU服务器,往往只关注GPU型号和数量。
但真正运行AI业务时,还需要关注完整的服务器配置。
包括:
GPU显存、CPU、系统内存、NVMe存储、网络带宽以及GPU之间的数据通信能力。
尤其是多GPU训练任务,如果服务器CPU、内存或网络成为瓶颈,即使部署了多张高性能GPU,也未必能够完全发挥硬件能力。
因此,企业选择GPU服务器租赁时,更合理的思路是:
先确定业务,再确定算力,再匹配服务器。
而不是单纯追求最高规格的GPU。
三、AI训练和AI推理,对GPU服务器的要求不同
同样是AI业务,训练和推理对于算力的需求并不完全相同。
模型训练
训练阶段通常需要较大的GPU计算能力,同时关注显存、多卡并行以及高速网络。
如果是大型模型,还需要考虑多台GPU服务器之间的数据交换效率。
模型推理
推理阶段更加关注显存容量、并发处理能力、响应速度和长期稳定运行。
例如企业部署AI客服、知识库、智能体或者内容生成平台时,GPU服务器可能需要持续运行。
因此,训练型GPU服务器和推理型GPU服务器不能简单按照同一套标准选择。
四、企业需要单卡还是多卡GPU服务器?
这是GPU服务器租赁中非常实际的一个问题。
如果主要进行:
模型测试;
算法开发;
轻量训练;
开发环境部署;
可以从单卡或者少量GPU资源开始。
如果涉及:
大模型训练;
模型微调;
多GPU并行计算;
高性能计算;
则需要进一步考虑多卡GPU物理服务器。
龙泽智能云在服务器产品体系中提供GPU服务器租赁,同时能够结合IDC机房、网络和服务器基础设施,为企业进一步扩展GPU算力提供部署条件。
对于业务刚刚起步的团队,可以先从较小规模算力开始;当模型和用户规模增加以后,再升级到多GPU服务器或集群。
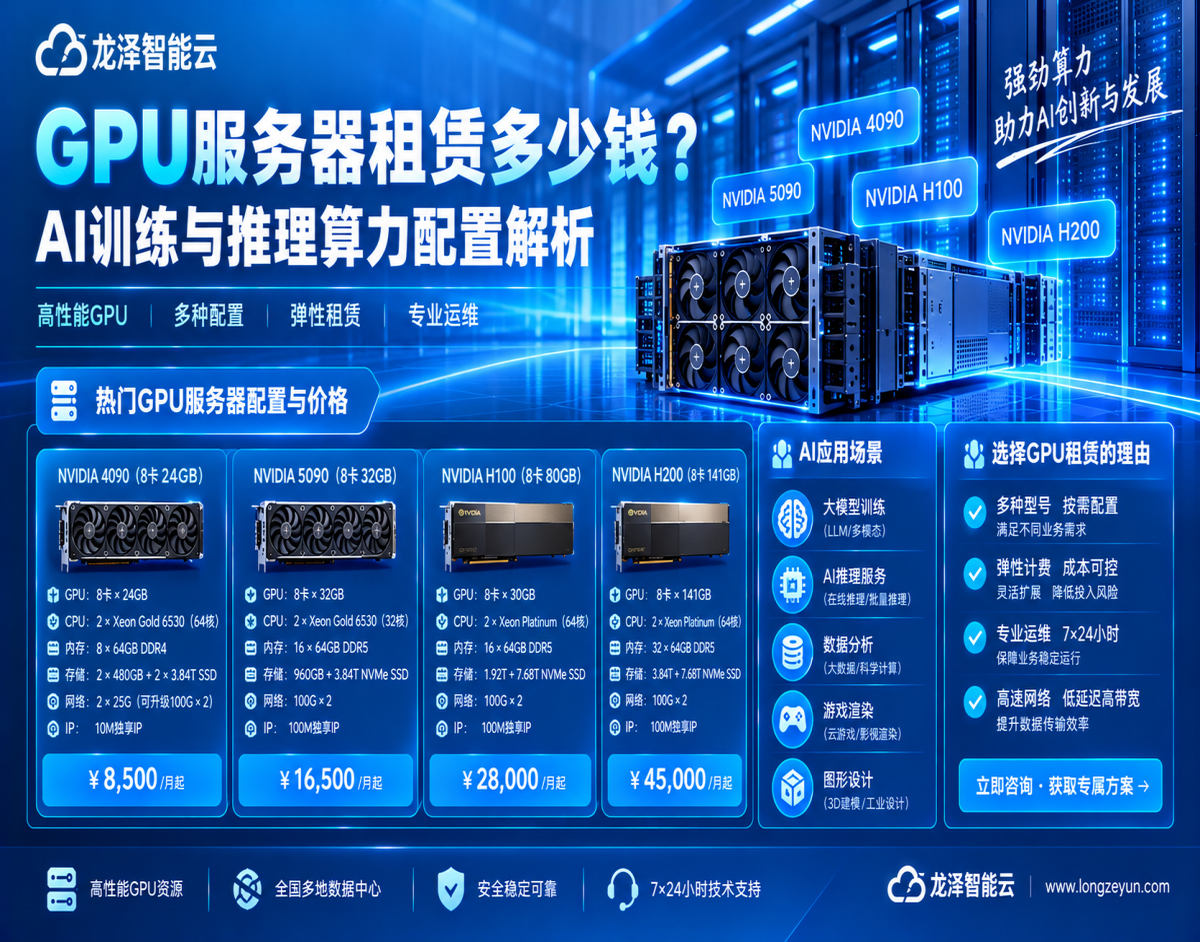
五、GPU服务器租赁价格,为什么不同平台差异明显?
企业搜索“GPU服务器租赁价格”时,经常会发现不同供应商报价差距很大。
原因在于GPU服务器并不是标准化商品。
影响价格的因素包括:
GPU型号、显存、GPU数量、CPU配置、内存、存储、网络、服务器是否独享以及租赁周期。
此外,GPU本身属于市场波动比较明显的硬件资源,库存和供需变化也会影响租赁价格。
所以企业不能只比较一个“月租”。
更应该计算:
GPU性能 + 显存 + 使用时长 + 任务完成效率 + 网络与存储能力
综合下来,才能判断实际算力成本。
六、郑州IDC网络资源,可以为GPU业务提供基础支撑
如果GPU服务器只是运行单机任务,网络要求相对简单。
但进入多节点AI训练以后,网络就变得非常重要。
龙泽智能云郑州数据中心资源覆盖电信、联通、移动及多线网络环境。
其中,中国电信中部(郑州航空港)数据中心位于河南重要网络节点,拥有多路由骨干光缆资源和大带宽接入能力;中国联通中原数据基地直连中国联通骨干网、河南省骨干网及郑州城域网核心,并建立了通往多个省市的直连电路。
对于需要服务河南及中部地区用户的AI企业来说,郑州的区域网络条件也为GPU服务器部署提供了较好的基础。
七、高速网络,是GPU集群发挥效率的重要组成部分
GPU服务器从单机走向集群以后,企业关注的就不只是公网带宽。
训练过程中,多台服务器之间需要频繁进行数据交换。
因此,企业需要同时关注:
节点间网络、上联能力、网络延迟和丢包情况。
龙泽智能云郑州联通数据中心采用核心路由器双节点冗余架构,并直连China 169骨干网、河南省骨干网和郑州城域网核心,每个单体960G上联骨干网;官网资料显示,相关线路至全国骨干网核心网络延时小于2ms。
对于AI训练、数据处理以及多服务器协同任务来说,这类数据中心网络资源值得重点考察。
八、香港IDC资源,则适合跨区域AI业务部署
如果企业的AI应用面向香港、东南亚或全球市场,服务器节点的位置同样重要。
龙泽智能云香港数据中心拥有CN2、BGP和国际网络等多种线路资源,其中部分机房汇聚PCCW、HGC、NTT及中国电信CN2等运营商,并通过BGP实现多线智能路由,多条国际海缆通达东南亚、日韩和欧美。
因此,对于同时面向大陆和海外用户的AI业务,可以根据用户分布进行节点规划。
例如:
大陆用户 → 郑州等国内节点;
香港及亚太用户 → 香港节点;
全球业务 → 香港国际线路或其他海外节点。
通过区域化部署,可以让GPU算力和业务访问更加匹配。
九、GPU服务器的运行环境,同样影响长期使用成本
高性能GPU服务器属于高功耗设备。
长期高负载工作时,对机房供电和散热能力都有较高要求。
龙泽智能云郑州电信航空港数据中心采用双路10KV供电,高低压配电采用2N架构,并配置柴发系统和UPS冗余;白沙数据中心则配备液冷散热系统和双路供电,并提供多运营商网络接入。
对于需要长期运行GPU服务器的企业来说,选择有成熟供电、散热和运维体系的数据中心,比单纯寻找低价GPU服务器更加重要。
十、为什么企业做AI项目,越来越倾向“租算力”?
AI项目的不确定性决定了企业很难准确预测未来的GPU需求。
项目开发期间可能只需要一两张GPU;
模型训练期间可能需要多卡;
产品上线之后,又可能更关注持续推理;
业务增长后,还需要扩充节点。
如果全部依赖自购硬件,企业需要承担设备闲置和迭代风险。
而租赁模式能够把算力需求分阶段管理。
验证阶段控制投入,训练阶段增加资源,生产阶段保持稳定,扩张阶段再进行集群扩容。
从行业发展趋势来看,这种灵活的算力使用方式正在受到更多关注。中国信通院2026年《智能算力服务研究报告》指出,智能算力服务正在由传统“资源供给”向“任务式交付”升级,用户越来越关注标准化、普惠化和精细化的算力服务。
十一、AI算力需求增长,也推动GPU租赁模式进一步成熟
国家数据局2026年8月公布数据显示,截至2026年7月底,全国智算总规模已经达到245万PFLOPS(FP16),145万PFLOPS智能算力已经纳入国家级监测调度平台。
同时,国家数据局指出,大模型正在加速向各行业落地,词元调用量快速增长,算力租赁商、模型厂商和技术服务机构等共同构成新的AI产业链。
这意味着GPU算力正在从少数AI研发机构使用的专业资源,逐渐成为企业可以直接采购和调用的基础生产能力。
十二、选择GPU服务器租赁,建议从“业务结果”反推配置
企业与其先问:
“H100多少钱?”
不如先回答:
“我要用GPU完成什么任务?”
如果是模型训练,就计算训练规模和显存需求;
如果是推理,就估算并发访问量;
如果是AIGC,就关注模型、显存和任务吞吐;
如果是多节点训练,则重点考察GPU互联和网络。
确定任务之后,再选择合适的GPU服务器,通常可以避免高规格资源浪费。
十三、龙泽智能云:从服务器资源到AI算力基础设施
龙泽智能云目前围绕服务器租用、GPU服务器租赁、服务器托管、机柜租用和AIDC等业务形成较完整的基础设施服务体系。
在传统IDC方面,郑州提供电信、联通、移动和三线等服务器及网络资源;在海外节点方面提供香港CN2、BGP和国际线路;同时还拥有面向高密度AI业务的算力基础设施。
这种资源体系对于企业来说,可以根据AI项目发展阶段进行组合:
GPU开发测试 → GPU服务器租赁 → 多卡GPU部署 → AIDC高电机柜 → GPU集群。
从单台设备到规模化算力,可以逐步升级,而不必一次性完成全部基础设施投入。
结语:GPU服务器租赁,让企业更灵活地获得AI算力
当前AI产业正在进入规模化应用阶段,智算资源持续扩张,大模型训练和推理需求不断增加。
对于企业而言,GPU服务器租赁正在成为连接AI应用和底层算力的一种重要方式。
选择GPU资源时,真正应该关注的并不是“配置最高”或者“价格最低”,而是:
GPU是否适合模型,显存是否够用,网络是否匹配,机房是否稳定,以及单位任务成本是否合理。
龙泽智能云依托郑州及香港IDC数据中心资源,提供服务器、网络、机房及算力基础设施服务,可根据企业AI训练、推理、开发测试和高性能计算需求进行资源匹配。
从一张GPU,到一台服务器,再到完整算力集群,企业可以按照业务增长逐步获取所需要的算力。
在AI算力需求快速增长的今天,与其提前承担大量硬件投入,不如让算力资源跟着业务走。
需要时快速部署,业务增长灵活扩容,让GPU服务器真正成为企业AI业务可以按需调用的生产力。