人工智能正在从技术验证逐步进入真实业务。
大模型训练、AI推理、知识库、智能体、数字人、机器视觉、视频生成、科学计算等应用不断增加,企业对GPU算力的需求也随之发生变化。
但对于很多企业来说,自己购买一整套GPU服务器并不是最轻松的选择。
一方面,高性能GPU服务器硬件投入较高;另一方面,企业还需要考虑服务器运维、数据中心、网络、供电、散热以及后续设备更新。因此,GPU服务器租赁正在成为企业获取AI算力的一种灵活方式。
中国信息通信研究院发布的《智能算力服务研究报告(2026年)》指出,随着大模型规模化落地,算力正在从传统计算资源向智能算力服务演进;同时,AI推理需求快速增长,算力需求正逐步从集中式训练向更加分布式的推理场景转变,企业对于“随时、随地、按需获取算力”的需求也更加明显。
这也意味着,GPU服务器市场正在从“买设备”逐渐向“按需使用算力”延伸。对于企业而言,真正需要考虑的已经不是简单的“哪张GPU最好”,而是:
什么型号适合自己的AI任务?
租GPU服务器还是直接购买?
需要多少显存?
CPU和内存怎么配?
训练与推理应该选择什么组网?
GPU数量未来怎么扩展?
龙泽智能云目前在服务器产品体系中提供GPU服务器租赁,并覆盖消费级GPU、数据中心GPU以及国产AI加速卡等多种算力资源。
一、为什么越来越多企业选择GPU服务器租赁?
如果企业只是偶尔运行AI测试任务,直接购买GPU服务器可能会出现设备利用率不足的问题。
例如,一个项目开发初期每天可能只需要几个小时GPU计算。
但服务器一旦购买,GPU、CPU、内存、存储和机房资源都已经产生固定投入。
而租赁模式可以让企业根据项目周期获得算力资源。
项目测试阶段:
租少量GPU。
模型训练阶段:
增加GPU服务器。
业务上线以后:
转为推理型算力。
项目结束:
释放资源。
这种模式特别适合:
AI创业团队;
大模型应用企业;
软件开发公司;
科研团队;
高校实验室;
机器视觉企业;
视频生成及渲染团队;
需要阶段性GPU算力的传统企业。
工信部2026年发布的《“人工智能+信息通信”创新发展实施意见》也提出提升智算云服务能力,面向模型研发、训练、部署提供全流程服务,并推动算力服务向更加灵活、市场化的模式发展。
因此,GPU服务器租赁已经不仅仅是“没有预算买服务器时的替代方案”,而逐渐成为AI项目获取算力的一种业务模式。
二、GPU服务器租赁,首先要解决的是“GPU型号怎么选”
龙泽智能云当前GPU服务器页面已经覆盖多个不同层级的GPU资源,包括:
RTX 4090;
RTX 5090;
A100;
A800;
H100;
H20;
H200;
H800;
B300;
以及昇腾910B、910C、海光P800等国产AI加速方案。
不同GPU之间在显存容量、算力能力、软件生态、组网方式和适用任务方面存在明显差异。
所以:
不能简单按照“型号越新越强”来选择。
企业应该先确定:
训练?
推理?
微调?
视觉?
生成式AI?
视频渲染?
科学计算?
再选择对应服务器。
三、4090 GPU服务器,适合AI项目的哪些阶段?
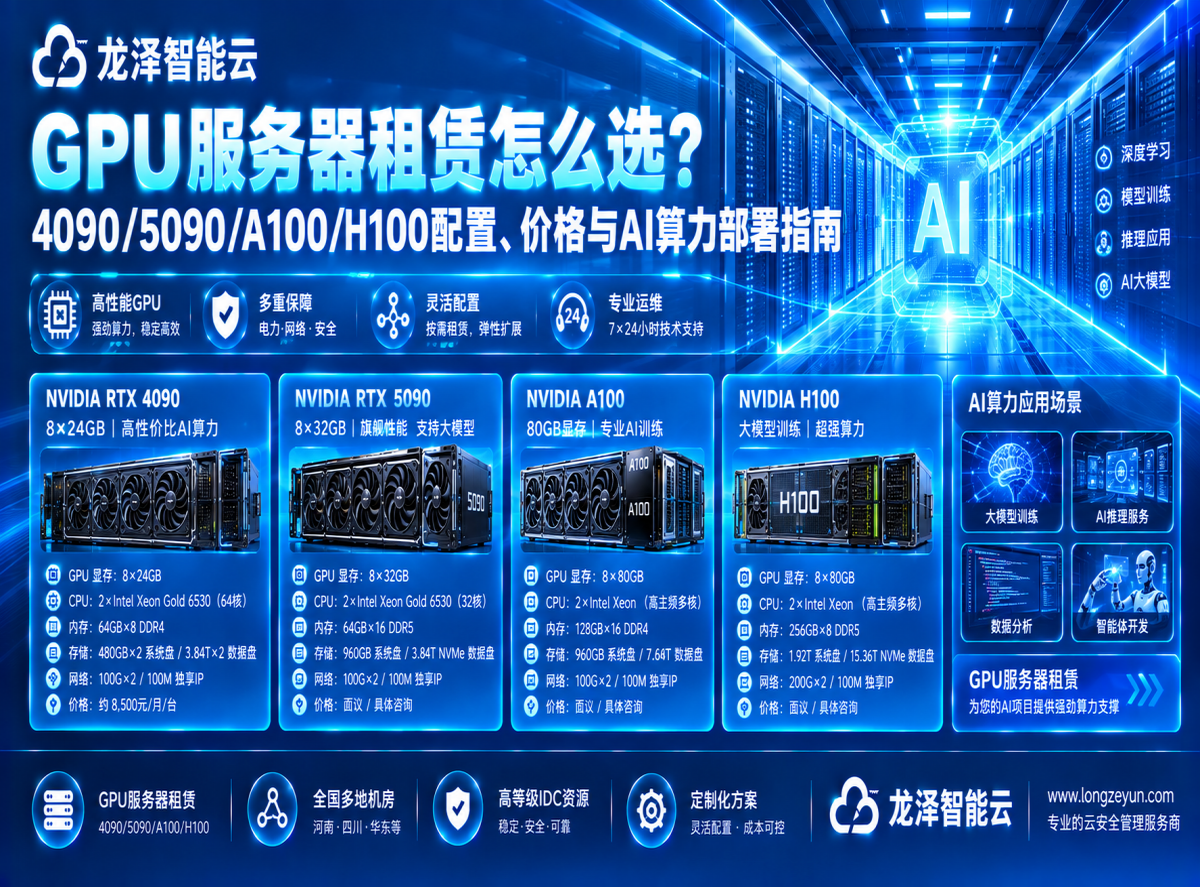
龙泽智能云目前展示的4090-8卡服务器,配置为:
8×4090 24GB;
2×Intel Xeon Gold 6530;
512GB DDR4内存;
480GB×2系统盘;
3.84TB×2 NVMe数据盘;
以太网组网;
100M带宽;
当前官网参考价格为8500元/月。
8张GPU形成较高的并行计算能力,同时每张卡拥有24GB显存。
这类服务器比较适合:
AI模型训练;
深度学习实验;
计算机视觉;
Stable Diffusion等生成式应用;
模型微调;
视频处理;
AI研发测试。
对于预算相对敏感、又需要较大GPU数量的团队,4090服务器可以作为一种算力租赁方案进行评估。
但企业选择时仍然需要根据具体模型、显存占用和软件环境进行测试。
四、5090 GPU服务器,适合哪些新一代AI应用?
龙泽智能云目前展示的5090-8卡服务器配置为:
8×5090 32GB;
2×Intel Xeon Gold 6530;
1024GB DDR5内存;
960GB系统盘;
3.84TB NVMe数据盘;
以太网组网;
100M带宽;
官网当前参考价格为16500元/月。
相比4090方案,5090配置的单卡显存提升至32GB,同时服务器采用更大容量的DDR5内存。
对于需要更大单卡显存的AI任务来说,可以重点考察这类配置。
例如:
视觉模型;
生成式AI;
模型微调;
AI内容生成;
高并行推理;
开发测试平台。
如果企业正在评估新GPU平台,可以从:
模型兼容性 + 显存需求 + 软件框架 + 实际性能
几个维度进行测试,而不是只比较GPU名称。
五、A100、A800,适合更加专业的AI计算场景
龙泽智能云目前同时提供A100、A800 8卡服务器。
其中:
A100-8卡-80GB
搭配AMD EPYC 7663、1024GB DDR4、NVMe存储,并采用IB组网,官网当前参考价格为40000元/月。
A800-8卡-80GB
搭配双路Intel Xeon Gold 6442Y、4TB NVMe数据盘,并采用IB组网,官网当前参考价格为36800元/月。
这类服务器更加适合:
大模型训练;
深度学习训练;
高性能AI推理;
科研计算;
多GPU协同计算。
尤其需要注意:
GPU数量多,不代表组网可以忽略。
当8张GPU进行大量数据交换时,服务器内部及GPU之间的数据通信效率会直接影响整体训练效率。
因此A100、A800这类高性能服务器采用IB组网,也是企业进行算力采购时值得重点关注的配置。
六、H100、H200、高端GPU服务器,为什么更关注“算力密度”?
龙泽智能云当前GPU服务器产品还提供H100、H200等更高等级的GPU资源。
官网当前展示:
H100-8卡-80GB:79000元/月;
H200-8卡-141GB:125000元/月。
这类服务器主要对应:
大模型训练;
复杂推理;
高性能AI计算;
科研计算;
大规模深度学习。
特别是H200方案,单卡显存达到141GB,在处理显存需求较高的模型任务时具有更强的资源承载能力。
因此,对于大型模型和高显存需求任务,企业应该重点关注:
单卡显存容量;
GPU数量;
GPU互联方式;
CPU与内存;
NVMe存储性能;
而不能只看“有8张GPU”。
七、国产AI算力,也正在成为企业GPU服务器租赁的重要方向
GPU服务器租赁市场并不只有NVIDIA路线。
随着国产AI芯片生态逐步发展,企业也开始关注不同芯片架构之间的软件兼容和算力适配。
龙泽智能云目前服务器页面提供:
910B-8卡-64GB;
910C-8卡-128GB;
P800-8卡-96GB
等国产算力方案。
其中:
910B-8卡-64GB
采用华为鲲鹏920 CPU、256GB DDR4内存、NVMe数据盘,并采用以太网组网,官网当前参考价格为23000元/月。
910C-8卡-128GB
采用华为鲲鹏920 CPU、256GB DDR4内存,官网当前参考价格为65000元/月。
P800-8卡-96GB
采用海光4号7490双路CPU、1.5TB DDR5内存,并采用以太网组网,官网当前参考价格为20000元/月。
对于需要评估国产AI算力生态的企业而言,这些产品可以作为实际测试与部署资源进行考察。
八、B300等新一代高端算力资源,适合什么任务?
龙泽智能云目前页面还展示了:
B300-8卡-288GB
服务器,搭配双路Intel Xeon 6767P、2×1920GB系统盘、8×3.84TB NVMe数据盘、IB组网和100M带宽,官网当前参考价格为260000元/月。
对于超大模型训练和高显存AI任务而言,显存规模已经越来越重要。
当模型参数量不断增加之后,单卡显存是否足够,会直接影响:
模型能否直接加载;
batch size能够达到多少;
是否需要模型切分;
是否需要更复杂的并行架构。
所以企业选择高端GPU时,应该把:
显存容量
放到与GPU计算性能同等重要的位置。
九、为什么GPU服务器租赁不能只比较“每月多少钱”?
这是企业最容易陷入的误区。
例如:
4090服务器8500元/月;
A100服务器40000元/月;
H100服务器79000元/月;
H200服务器125000元/月。
如果只看价格,自然会觉得差异非常大。
但这些服务器所对应的:
GPU型号、显存、CPU、内存、存储和组网
完全不同。
因此,正确的GPU服务器价格比较方式应该是:
价格 ÷ 实际可用GPU资源 ÷ 业务性能
而不是:
价格越低越好。
一个8500元的服务器,如果企业需要运行H100才能完成的任务,那么价格再低也无法替代H100。
反过来,如果普通GPU已经能够完成任务,直接使用高端GPU也可能造成资源浪费。
十、AI训练与AI推理,对GPU服务器的要求并不一样
随着AI应用进入生产环境,训练和推理的资源需求正在进一步分化。
中国信息通信研究院2026年《智能算力服务研究报告》指出,随着大模型应用增长,推理需求正在快速提升,未来智能算力需求的结构可能进一步向推理侧倾斜。
因此企业选择GPU服务器时,需要先区分:
AI训练
更加关注:
GPU数量;
GPU互联;
显存;
计算效率;
高速存储;
数据吞吐。
AI推理
更加关注:
单卡显存;
并发能力;
响应速度;
单位Token成本;
模型加载效率;
GPU利用率。
同一个GPU型号,在不同业务中的性价比可能完全不同。
这也是为什么现在的GPU算力采购越来越强调“按任务选择算力”。
十一、GPU服务器租赁,为什么比“一次性购买”更适合部分AI项目?
AI项目最大的特点之一,就是:
技术变化快。
今天企业需要一种GPU。
半年之后,可能又需要更高显存的GPU。
如果企业自己购买整套设备,就需要承担硬件折旧、升级和资产管理成本。
而GPU服务器租赁可以降低这种硬件迭代压力。
比如:
项目开发阶段租4090;
模型规模扩大后租5090;
训练阶段使用A100/A800;
大型模型项目使用H100/H200;
国产化项目测试910B/910C。
根据不同项目选择相应GPU资源。
这种模式尤其适合:
AI创业企业、研发团队、科研机构以及项目型AI应用。
十二、GPU服务器真正的核心,不只是GPU
一台GPU服务器的整体性能,并不能只用GPU型号描述。
例如龙泽智能云当前产品中:
4090方案:
8×4090 + 512GB内存 + NVMe存储。
5090方案:
8×5090 + 1TB DDR5。
A100:
8×80GB + IB组网。
H200:
8×141GB + IB组网。
B300:
8×288GB + IB组网 + 多块NVMe。
这些配置背后反映的是一个完整系统:
GPU + CPU + 内存 + 存储 + 网络
共同决定最终的AI计算能力。
所以企业采购GPU服务器时,不能只问:
“有几张卡?”
还应该问:
“CPU是什么?”
“内存多少?”
“NVMe多少?”
“GPU怎么组网?”
“带宽多少?”
十三、为什么IB组网对多GPU训练很重要?
如果一台服务器只有一张GPU,GPU之间几乎不存在协同问题。
但如果一次使用:
8张GPU。
就会产生大量GPU之间的数据交换。
当任务进一步扩展到:
多服务器、多机柜、多GPU集群
以后,网络互联效率会进一步影响训练任务。
龙泽智能云A100、A800、H100、H20、H200、H800、B300等高端GPU服务器页面均采用IB组网。
这类方案更加适合需要GPU之间高效通信的任务。
对于模型训练而言:
GPU计算能力很重要,但GPU之间如何通信同样重要。
十四、GPU服务器的NVMe存储为什么不能忽略?
AI训练并不是GPU一直空转。
GPU需要持续读取:
训练数据;
模型文件;
缓存;
中间结果。
如果磁盘IO速度跟不上,GPU就可能等待数据。
因此,AI服务器越来越多采用大容量NVMe高速存储。
龙泽智能云当前不同GPU服务器都配置了NVMe数据盘:
4090:3.84TB×2;
5090:3.84TB;
A800:3.84TB×4;
H100:3.84TB×4;
B300:3.84TB×8。
对于大模型和AI数据处理任务而言,这种高速本地存储可以作为整体系统性能规划的一部分。
十五、企业租GPU服务器,应该怎么判断需要几张GPU?
不要直接从:
“我要8张卡。”
开始。
应该先回答:
模型多大?
显存需要多少?
训练还是推理?
并发多少?
训练数据多大?
训练周期多长?
是否需要分布式训练?
例如:
小规模模型微调,可能只需要少量GPU。
中型模型训练,可以使用多GPU服务器。
大型模型训练,则可能需要多台8卡GPU服务器组成集群。
AI推理则可能根据用户并发量增加GPU数量。
因此,GPU数量实际上由:
模型规模 + 显存需求 + 计算量 + 并发量
共同决定。
十六、龙泽智能云为什么不只是“租GPU服务器”?
龙泽智能云成立于2021年,总部位于河南郑州。
官网目前介绍,公司已经形成:
大模型API;
云计算;
全栈技术开发;
IDC互联网数据中心;
AIDC智能算力中心
五大业务支柱。
这意味着企业使用GPU服务器后,还可以进一步接入其他基础设施。
例如:
GPU服务器 + 大模型API
适合AI应用开发。
GPU服务器 + 云数据库
适合企业AI业务系统。
GPU服务器 + 对象存储
适合AI数据集和文件管理。
GPU服务器 + CDN
适合面向大量用户的AI应用。
GPU服务器 + AI智能体
可以进一步将模型能力连接到具体业务流程。
这样,GPU服务器就不是孤立的“算力机器”,而是企业整个AI应用架构的一部分。
十七、龙泽智能云的AIDC能力,可以解决GPU服务器放在哪里的问题
GPU服务器功耗明显高于普通服务器。
如果企业购买或租用多台GPU服务器,还需要解决:
供电;
散热;
机柜;
网络;
运维。
龙泽智能云已经形成AIDC智能算力中心业务。
官网介绍显示,公司提供:
4KW—120KW高功率机柜;
液冷散热;
GPU集群
等资源,可以满足AI训练、大模型推理等高算力场景。
因此,企业可以从:
GPU服务器租赁
进一步延伸到:
GPU服务器 + 高电机柜 + AIDC基础设施。
这对于从单机AI实验逐步发展到多机GPU集群的企业来说更加方便。
十八、郑州正在形成GPU和人工智能算力产业基础
GPU服务器租赁市场的发展,与当地算力基础设施密切相关。
郑州市当前已经建成40余个数据中心,已投用智算超过4.5万P,并持续推进国家超算互联网核心节点、郑州人工智能计算中心以及算力网络建设。
郑州市2026年“人工智能+”行动方案明确提出强化算力、数据、模型等支撑能力,并保障AI模型训练、部署、推理等环节对算力、存储、网络和安全的需求。
同时,郑州相关政府部门也提出支持适用于大模型训练、模型推理、视觉渲染等高性能并行计算场景的人工智能服务器和软硬件一体化设备发展。
这为郑州GPU服务器和智能算力服务的发展提供了较好的产业环境。
十九、GPU服务器租赁价格,龙泽智能云目前有哪些选择?
按照龙泽智能云服务器页面当前展示的参考价格,可以形成一个比较直观的产品梯度:
| GPU服务器 | GPU配置 | 当前官网参考价 |
|---|---|---|
| 4090 | 8×24GB | ¥8,500/月 |
| 5090 | 8×32GB | ¥16,500/月 |
| A800 | 8×80GB | ¥36,800/月 |
| A100 | 8×80GB | ¥40,000/月 |
| 910B | 8×64GB | ¥23,000/月 |
| P800 | 8×96GB | ¥20,000/月 |
| H800 | 8×80GB | ¥70,000/月 |
| H100 | 8×80GB | ¥79,000/月 |
| H20 | 8×141GB | ¥50,000/月 |
| H200 | 8×141GB | ¥125,000/月 |
| 910C | 8×128GB | ¥65,000/月 |
| B300 | 8×288GB | ¥260,000/月 |
以上为龙泽智能云服务器页面当前展示的月度参考价格,具体库存、机房、合同周期及最终报价应以实际咨询和商务确认结果为准。
从产品梯度可以看到,GPU服务器租赁并不是只有一种选择。
从:
4090/5090
到:
A100/A800
再到:
H100/H200/B300
以及:
910B/910C/P800
可以覆盖不同预算、不同软件生态以及不同AI任务需求。
二十、哪些企业适合直接考虑GPU服务器租赁?
AI创业团队
需要快速搭建模型测试和产品开发环境。
大模型应用企业
需要GPU运行推理服务。
软件开发公司
需要为客户开发AI应用或者智能体。
视觉AI企业
机器视觉、图像识别、视频分析等业务需要GPU计算。
数字内容企业
AI绘图、视频生成、3D渲染等需要高并行计算资源。
科研教育机构
涉及深度学习、模拟计算和数据分析。
企业AI私有化项目
需要部署专属GPU服务器和模型环境。
对于这些企业来说,租赁GPU服务器的最大价值在于:
先获得算力,再根据实际项目增长调整资源。
二十一、企业选择GPU服务器时,建议重点看这七项
第一,看显存。
模型是否能够装下,显存是最基础的门槛。
第二,看GPU数量。
是单卡、多卡还是多服务器集群?
第三,看CPU和内存。
不要让GPU等待CPU或数据。
第四,看存储。
AI数据集和模型文件通常对NVMe性能有较高要求。
第五,看组网。
多GPU训练需要关注GPU间通信。
第六,看机房。
高功率GPU服务器需要稳定的供电和散热环境。
第七,看服务商。
是否能够继续提供云、网络、机柜、大模型API和AI开发支持。
这几个条件应该整体考虑。
结语:GPU服务器租赁,真正租的是一套可使用的AI算力资源
AI的发展正在推动算力需求快速增长。
与此同时,企业获取算力的方式也在发生变化。
过去:
购买服务器。
现在:
租GPU服务器。
未来则可能进一步发展为:
按需获取算力 + 多GPU调度 + 模型服务 + AI应用
的综合模式。
中国信息通信研究院2026年报告指出,随着大模型规模化落地和推理需求增长,智能算力服务正在向更加灵活的服务模式演进。 工信部也明确提出提升智算云服务能力、构建算力互联互通体系,并推动算力服务更加集约化、市场化。
对于企业来说,GPU服务器租赁的关键不在于追逐最新、最贵的GPU,而是找到:
与模型匹配的显存、与任务匹配的GPU数量、与数据匹配的存储、与集群匹配的网络,以及与项目预算匹配的算力成本。
龙泽智能云当前GPU服务器产品覆盖4090、5090、A100、A800、H100、H20、H200、H800、B300以及910B、910C、P800等多类GPU及AI加速卡资源,并提供不同CPU、内存、NVMe存储和IB/以太网组网方案。
同时,龙泽智能云已经形成大模型API、云计算、全栈开发、IDC互联网数据中心和AIDC智能算力中心五大业务支柱,可以进一步提供云服务器、数据库、对象存储、CDN、安全防护、高电机柜、AI智能体及AI解决方案等配套服务。
这意味着企业可以从:
一台GPU服务器
开始,
再逐步升级到:
多GPU服务器 → GPU集群 → 高电机柜 → AIDC算力中心 → 大模型与AI应用。
对于正在寻找GPU服务器租赁、GPU算力租赁、4090服务器、5090服务器、A100服务器、H100服务器、H200服务器、国产GPU服务器、AI训练服务器、AI推理服务器的企业,可以结合模型规模、显存需求、训练/推理任务和预算选择对应方案。
龙泽智能云|专业的云安全管理服务商
GPU服务器租赁 + GPU算力 + AIDC高电机柜 + 大模型API + AI开发,为企业提供从算力硬件到AI应用的一体化技术服务。
正在规划GPU算力的企业,可直接提供模型类型、训练/推理需求、GPU数量、显存需求及预计使用周期,咨询4090、5090、A100、A800、H100、H200及国产AI算力服务器方案,获取当前库存、配置与最新报价。